认真看待缩放定律
原文:Lilian Weng, Scaling Laws, Carefully, Lil’Log, June 24, 2026。本文为中文译文,保留原文主要公式、图示与引用。
缩放定律是深度学习中最关键的经验发现之一。它的观察形式很简单:随着模型规模 \(N\)、数据集规模 \(D\) 和计算量 \(C\) 增大,训练损失 \(L\) 会按照幂律曲线可预测地下降;在 log-log 图上,这条曲线会表现为一条直线。我们可以把缩放定律看作描述计算量、损失、模型规模和数据之间关系的一套框架;其核心问题是,如何在 \(N\) 和 \(D\) 之间最优地分配宝贵的计算资源。
这种可预测性让缩放定律在实践中非常有价值。常见做法是先用少量小规模训练实验拟合缩放定律,然后外推估计更大模型所需的 token 数和计算量。
| 符号 | 含义 |
|---|---|
| \(N\) | 模型规模,通常以参数量衡量。 |
| \(D\) | 训练数据集规模,通常以 token 数衡量。 |
| \(C\) | 训练计算量,单位为 FLOPs。一个有用近似是 \(C \approx 6ND\)(Kaplan et al. 2020),其中 \(2ND\) 对应前向传播,\(4ND\) 对应反向传播。 |
| \(E\) | 不可约损失。 |
| \(L, \hat{L}(.)\) | 测试损失或测试损失预测函数;因为训练损失和测试损失强相关,也可指训练损失。 |
| \(\epsilon\) | 泛化误差。 |
早期工作:机器学习损失的可预测性
在缩放定律成为主流概念之前,研究者已经开始探索泛化误差随规模变化的可预测性。
Amari et al. (1992) 用贝叶斯方法和退火近似推导了四类学习曲线:
- 确定性学习算法、无噪声数据、唯一解:\(\epsilon \sim c \cdot D^{-1}\),其中 \(c\) 是某个常数。
- 确定性学习算法、无噪声数据、多个等价解:\(\epsilon \sim c \cdot D^{-2}\)。每增加一个数据点,学习会更快,因为模型只需要学习最优参数流形,而不是寻找单个解点。
- 确定性学习算法、有噪声数据:\(\epsilon \sim c \cdot D^{-1/2}\)。数据噪声会让学习更困难。
- 随机学习算法、有噪声数据:\(\epsilon \sim c \cdot D^{-1} + E\)。这里不可约损失 \(E\) 是随机学习器无法继续降低的残余误差,例如模型在大数据上耗尽容量时的误差。四类学习曲线都遵循幂律:
其中 \(E\) 可以为 0,\(\alpha = -2, -1, -1/2\)。尽管他们的理论设定基于一个简化的二分类任务,但它为构建经验性的机器学习损失预测模型指明了一个有用方向。
早期经验研究中,Hestness et al. (2017) 解释了泛化误差、模型规模和数据之间的关系。对于给定训练数据量,他们通过网格搜索找出最佳拟合模型规模,然后绘制损失相对于训练数据量的变化。在深度学习的四个不同领域中,神经机器翻译、图像分类、语言建模和语音识别都反复出现了如下模式:
- 泛化误差会随某些因素,例如数据规模,呈幂律缩放。
- 模型改进会平移误差曲线,但似乎不会改变幂律指数。
- 有趣的是,架构会改变幂律拟合的偏移项 \(E\),但不会改变指数 \(\alpha\)。幂律斜率看起来更像是问题领域的属性,而不是模型架构的属性。
- 拟合规模为 \(D\) 的数据集所需的模型参数量 \(N\) 也遵循幂律。
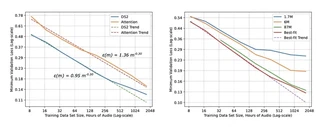
图:左侧是 Deep-Speech-2 与 attention speech model 的学习曲线,右侧是不同规模 DS2 模型的学习曲线。小模型在训练数据变大时会进入损失平台期。图片来源:Hestness et al. 2017。
一个概念图可以把学习曲线分成三个阶段。在小数据区域,学习信号不足,模型只比随机猜测略好。中间的“幂律区域”中,我们会观察到损失、数据和模型规模之间的幂律关系。最后的不可约误差区域可以归因于数据噪声等因素。
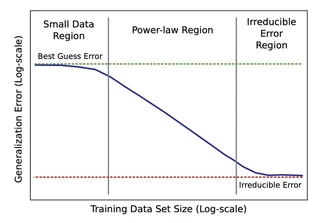
图:幂律学习曲线阶段示意图。图片来源:Hestness et al. 2017。
Rosenfeld et al. (2020) 进一步尝试把误差建模为模型规模 \(N\) 和数据规模 \(D\) 的联合函数,覆盖多种架构(ResNet、WRN、LSTM、Transformer)和优化器(Adam、SGD 变体)。经验上,他们观察到,当固定其中一个轴时,误差会随另一个轴按照幂律下降:
\[ \hat{L}(D,N) \approx \frac{A}{N^{\alpha}} + E_N,\quad \hat{L}(D,N) \approx \frac{B}{D^{\beta}} + E_D \]它们可以组合成一个联合形式:
\[ \hat{L}(D, N) \approx \frac{A}{N^{\alpha}} + \frac{B}{D^{\beta}} + E \]其中 \(A > 0, B > 0, \alpha \geq 0, \beta \geq 0\) 是标量常数,\(E\) 不依赖于 \(N\) 或 \(D\)。
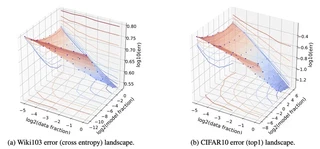
图:数据规模、模型规模和泛化误差在 log-log-log 尺度上的 3D 等高线图。蓝点来自经验实验,曲面是蓝点之间的线性插值。图片来源:Rosenfeld et al. 2020。
因此,他们可以用一个简单的参数函数 \(\boldsymbol{\theta} = \langle A, B, E, \alpha, \beta \rangle\) 建立预测模型,只通过训练一组较小配置 \((D, N)\) 的实验,就能预测超过某些阈值时 \((D, N)\) 对应的期望损失。
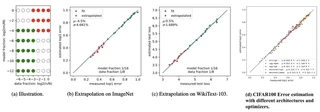
图:在小规模配置上拟合参数化误差模型,并外推到更大的模型和数据规模:(a)实验设置示意;(b)ImageNet、(c)WikiText-103 和(d)CIFAR100 上的误差估计,包含三种架构(WRN、VGG、DenseNet)和两种优化器(SGD、Adam)。图片来源:Rosenfeld et al. 2020。
旁注:这些早期工作依赖一些经典学习理论直觉,例如把 VC 维(模型能够打散的最大点集大小)作为容量代理。但在现代深度学习中,VC 维往往太粗糙,难以解释真实行为;经验幂律最终比最坏情况理论界更清晰,也更实用。
数据无限区域中的缩放定律
Kaplan et al. 的缩放定律
Kaplan et al. (2020) 在语言建模社区推广了缩放定律这个概念。他们发现,在多个数量级范围内,交叉熵测试损失 \(L\) 会分别随模型规模 \(N\)(不含 embedding 层)、数据集规模 \(D\) 和训练计算量 \(C\) 呈幂律缩放。这些发现与上一节早期工作一致,但 Kaplan et al. 用 Transformer 语言模型和更大规模的经验实验把这个概念形式化了。他们的模型规模范围从 768M 到 1.5B 非 embedding 参数,数据集规模从 22M 到 23B token。论文中的所有训练都使用 3000 step 线性 warmup,然后余弦衰减到 0 的学习率计划。
关键发现包括:
- 损失 \(L\) 会分别随 \(N\)、\(D\)、\(C\) 呈幂律缩放;为了达到最优性能,三者都必须一起扩展。
- 训练曲线遵循可预测的幂律,并且其参数大体独立于模型规模。
- 更大的模型样本效率更高,也就是说,它们可以用更少优化步数和更少数据点达到给定损失。
- 架构细节,例如宽度、宽高比等,相比纯粹规模没有那么重要。
- 训练损失和测试损失正相关。(听起来显然,但这是预训练工作的基础。另一方面,预训练损失的改善能否迁移到 post-training 评测,需要单独研究。)
- 在固定计算预算下,训练一个非常大的模型并在收敛前停止,比把一个较小模型完整训练到收敛更高效。这一点正是 Chinchilla 缩放定律在下一节中反对的地方:Kaplan et al. 因为拟合出的指数更大,高估了最优模型规模。
他们用一个方程总结 \(N\) 和 \(D\) 的联合依赖关系:
\[ \hat{L}(N,D) = \left[ \left(\frac{a}{N}\right)^{\frac{\alpha}{\beta}} + \frac{b}{D} \right]^{\beta} \]这个形式有一个不错的推论:过拟合程度,也就是模型复杂或数据过少,主要取决于比值 \(N^{\alpha / \beta} / D\)。这说明为了避免训练进入数据受限状态,数据需要按照某种特定比例随模型规模增长。
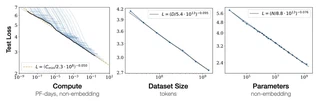
图:测试损失随计算量、数据集规模和参数量呈幂律变化,覆盖多个数量级。图片来源:Kaplan et al. 2020。
最有影响力、事后看也最有争议的结论,是关于 compute-optimal 分配。Kaplan et al. 发现 \(N_\text{opt} \propto C^{0.73}\),并认为模型规模应该比数据集规模增长得更快。具体来说,计算量增加 10 倍时,他们建议模型规模扩大约 5.5 倍,而训练 token 只扩大约 1.8 倍。之后 Chinchilla 论文推翻了这个建议,认为这样会让大模型严重训练不足。
Kaplan et al. 中另一个有用分析,是基于 \(D\) 和 \(N\) 估算所需训练 FLOPs。每个 multiply-add 被计为约 2 FLOPs。
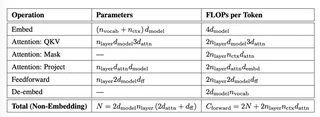
图:给定层数 \(n_\text{layer}\)、模型宽度 \(d_\text{model}\)(即 \(d_\text{embed}\),原表中符号不完全一致)、前馈层维度 \(d_\text{ff}\)(通常等于 \(4d_\text{model}\))、attention 维度 \(d_\text{attn}\)(通常等于 \(d_\text{model}\))、上下文长度 \(n_\text{ctx}\) 和词表大小 \(n_\text{vocab}\) 时,不同 Transformer 组件的参数与计算量估算。图片来源:Kaplan et al. 2020。
在标准配置 \(d_\text{attn} = d_\text{model} = d_\text{ff}/4\) 下,并且从 \(N\) 和每 token 前向计算中排除 embedding 层:
\[ \begin{align} N &= n_\text{layer} d_\text{model} 3 d_\text{attn} + n_\text{layer} d_\text{attn} d_\text{model} + n_\text{layer} 2 d_\text{model} d_\text{ff} & \small{\text{; no embedding layer}} \\ &= 2\;n_\text{layer} d_\text{model}(2d_\text{attn} + d_\text{ff}) & \\ &= 12\;n_\text{layer} d_\text{model}^2 & \\ \\ C_\text{fwd} &= 2 n_\text{layer} (d_\text{model} 3 d_\text{attn} + n_\text{ctx}d_\text{attn} + d_\text{attn}d_\text{embed} + 2 d_\text{model} d_\text{ff}) & \\ &= 2 n_\text{layer} (12 d_\text{model}^2 + n_\text{ctx}d_\text{attn}) & \\ &= 2N + 2 n_\text{layer}n_\text{ctx}d_\text{attn} & \\ &\approx 2N \quad\quad \small{\text{; assuming }n_\text{ctx} < 12 d_\text{model} \text{ and the }n_\text{ctx}\text{ term is relatively small.}}\\ \end{align} \]然后,我们把反向传播 FLOPs 计为前向传播 FLOPs 的两倍,因为反向传播会运行两次矩阵乘法,分别计算输入激活和权重的梯度。因此,总训练 FLOPs 每 token 约为 \(6N\),在 \(D\) 个 token 上训练的总 FLOPs 约为 \(C \approx 6ND\)。
Chinchilla 缩放定律
Chinchilla 论文(Hoffmann et al. 2022)用更仔细的实验设计,研究固定计算预算 \(C\) 下最优模型规模 \(N\)(总参数量,包含 embedding)和 token 数 \(D\) 的关系,并得出了一个与 Kaplan et al. 有些不同的答案。
图:你应该知道 Chinchilla 长什么样。图片来源:ChatGPT 生成。
核心问题是:在约束 \(\text{FLOPs}(N, D) = C \approx 6ND\) 下,应该如何分配资源?换句话说,当 FLOPs 有限,也就是只有给定数量 GPU 和给定训练时间时,我们该如何在更多数据 token 和更多模型参数之间做选择?
\[ N_\text{opt}(C), D_\text{opt}(C) = \operatorname*{arg\,min}_{\text{s.t. } \text{FLOPs}(N,D) = C} \hat{L}(N, D) \]Chinchilla 论文提出了三种设计整洁的缩放定律拟合方法。
他们的经验实验扫描了超过 400 个模型,规模从 70M 到超过 16B 参数,训练 token 从 5B 到 500B。实验假设每个训练 token 都是唯一的,即数据无限区域。所有训练都使用余弦学习率计划,在训练过程中衰减 10 倍。扫过模型规模会描出 compute-optimal 前沿。
方法 1:固定模型规模,改变 token 预算
对于每个参数量 \(N\),用不同 token 预算训练多个 run,并记录每个 FLOP 预算 \(C\) 下达到的最小损失。
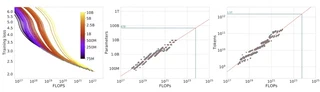
图:Chinchilla 方法 1:对一组模型规模扫描 FLOP 预算上的训练损失曲线。图片来源:Hoffmann et al. 2022。
方法 2:IsoFLOP profiles
固定计算预算 \(C\),绘制最终损失相对于参数量 \(N\) 的曲线。每条 iso-FLOP 曲线在 log 空间中大致像一个抛物线,它的最低点标记该计算预算下的最优模型规模。重复多个预算后,就能在图上描出一条幂律线。
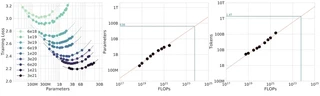
图:Chinchilla 方法 2:IsoFLOP 抛物线,每条曲线的最低点就是该预算下的 compute-optimal 模型规模。图片来源:Hoffmann et al. 2022。
方法 3:参数化拟合
直接拟合与 Rosenfeld et al. (2020) 相同的参数函数:
\[ \hat{L}(N, D) = \frac{A}{N^\alpha} + \frac{B}{D^\beta} + E \]在约束 \(\text{FLOPs}(N,D) = C \approx 6ND\) 下最小化 \(\hat{L}(N, D)\),其实可以得到最优 \(N_\text{opt}(C), D_\text{opt}(C)\) 的闭式近似。
首先把表达式化简成只包含 \(N\):
\[ \begin{align} \hat{L}(N) &= A N^{-\alpha} + B \Big(\frac{C}{6}\Big)^{-\beta}N^\beta + E \\ \hat{L}'(N) &= -\alpha A N^{-\alpha-1} + \beta B \Big(\frac{C}{6}\Big)^{-\beta} N^{\beta -1} = 0 & \small{\text{; derivative wrt }N\text{ should be zero.}} \\ \text{Thus}\quad & \alpha A N^{-\alpha-1} = \beta B \Big(\frac{C}{6}\Big)^{-\beta} N^{\beta -1} \\ & \alpha A = \beta B \Big(\frac{C}{6}\Big)^{-\beta} N^{\alpha + \beta} \\ & N_\text{opt} = \Big(\frac{\alpha A}{\beta B}\Big)^{\frac{1}{\alpha + \beta}} \Big(\frac{C}{6}\Big)^{\frac{\beta}{\alpha+\beta}} \\ & D_\text{opt} = \frac{C}{6 N_\text{opt}} = \Big(\frac{\beta B}{\alpha A}\Big)^{\frac{1}{\alpha + \beta}} \Big(\frac{C}{6}\Big)^{\frac{\alpha}{\alpha+\beta}} \end{align} \]当 \(\alpha \approx \beta\) 时,模型规模和训练 token 数应该以相同速度扩展。
为了找到最优 \(\boldsymbol{\theta} = \langle A, B, E, \alpha, \beta\rangle\),Chinchilla 论文采用 Huber loss(对异常值鲁棒,\(\delta=10^{-3}\))和 L-BFGS 算法(适合参数量较少的曲线拟合)。
\[ \begin{align} \min_{A,B,E,\alpha,\beta} \sum_{\text{runs }\{i\}} \text{Huber}_\delta (\log \hat{L}(N_i, D_i) - \log L_i) \\ \text{ where }\text{Huber}_\delta (x) = \begin{cases}\frac{1}{2} x^2 & \text{for }\vert x \vert \leq \delta \\ \delta \cdot (\vert x \vert - \frac{1}{2}\delta), & \text{otherwise.}\end{cases} \end{align} \]Chinchilla 通过三种互补方法得到最终答案,而且三者结果彼此一致,这也是该结论很有说服力的一部分原因。
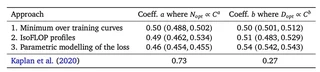
图:三种方法都指向一个 compute-optimal 前沿,其中 \(N_\text{opt} \propto C^{0.5}\),但它们与 Kaplan et al. 不一致。注意,方法 3 的结果与另外两种方法稍有偏差,后文会解释。图片来源:Hoffmann et al. 2022。
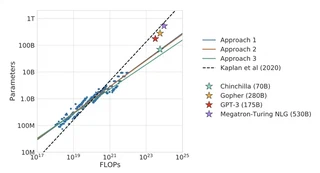
图:Chinchilla 三种预测方法以及 Kaplan et al. (2020) 预测的对比图。三种方法都表明,当时几个主流 LLM 训练不足。图片来源:Hoffmann et al. 2022。
Chinchilla 论文认为当时(约 2022 年)多数大模型训练不足,这一点有一个著名例证:在与 Gopher(Rae et al. 2021,280B 参数、300B token 预算)相同计算预算下,他们训练了 Chinchilla(70B 参数、1.4T token 预算)。这个模型参数量小了 4 倍,但训练 token 约多了 4 倍,并且在各项任务上全面超过 Gopher。
调和 Kaplan 和 Chinchilla
Chinchilla 缩放定律与 Kaplan et al. 的分歧如下:
- Kaplan 的结论是“模型增长要快于数据”(\(N_\text{opt} \propto C^{0.73}\));Chinchilla 的结论是,每当模型规模翻倍,训练 token 数也应该翻倍(\(N_\text{opt} \propto C^{0.5}\))。
- Kaplan 的结论是“训练一个大模型并在收敛前停止”;Chinchilla 的结论是,应该训练一个更小模型,并用更多数据。
两篇论文仍然同意同一个基本原则,但它们对最优模型规模与 token 之间权衡点的判断差异很大。为什么会差这么多?
差异 1:Kaplan et al. 主要在小模型上实验。 Kaplan et al. 的实验主要集中在较小模型,而 Chinchilla 论文的实验规模超过前者 10 倍以上。当我们在 log-log 空间外推时,拟合上的一点小差异就可能导致很大的结果差异,后面的玩具模拟也展示了这一点。
差异 2:小模型中 embedding 参数量很重要。 在小参数区域,embedding 参数是总参数量中不可忽略的一部分,因此是否计入 embedding 很重要。Pearce & Song (2024) 沿着这个方向做了细致分析。我们用 \(N_{\setminus E}, C_{\setminus E}\) 表示排除 embedding 时的模型规模和计算量,用 \(N, C\) 表示总参数量和总计算量。
- Kaplan et al.: \(N^*_{\setminus E} \propto C^{0.73}_{\setminus E}\)(不含 embedding)
- Chinchilla: \(N^* \propto C^{0.50}\)(总参数量)
为了把两者联系起来,他们为总参数量 \(N_T\) 和非 embedding 参数量 \(N_{\setminus E}\) 拟合了如下关系,其中 \(\omega\) 是常数:
\[ N = N_{\setminus E} + \omega\, N_{\setminus E}^{1/3}. \]这个形式有一些不错的性质:它严格单调递增,而且 \(\lim_{N \to \infty} N = N_{\setminus E}\),因为 \(\frac{N}{N_{\setminus E}} = 1 + \omega {N_{\setminus E}}^{- \frac{2}{3}}\),所以 \(\lim_{N_{\setminus E} \to \infty} \frac{N}{N_{\setminus E}} = 1\)。
把它代入 Chinchilla 定律方程:
\[ \begin{align} L(N_{\setminus E}, C_{\setminus E}) &= A(N_{\setminus E} + \omega\, N_{\setminus E}^{1/3})^{-\alpha} + B \Big(\frac{C_{\setminus E}}{6}\Big)^{-\beta} N_{\setminus E}^\beta + E \\ L'(N_{\setminus E}, C_{\setminus E}) &= - \alpha A (N_{\setminus E} + \omega N_{\setminus E}^{1/3})^{-\alpha -1}(1 + \frac{\omega}{3}N_{\setminus E}^{-2/3}) + \beta B \Big(\frac{C_{\setminus E}}{6}\Big)^{-\beta} N_{\setminus E}^{\beta -1} = 0 & \small{\text{; derivative wrt }N_{\setminus E}\text{ should be zero.}} \\ \text{Rearrange to get }& \alpha A (N^{*}_{\setminus E} + \omega {N^{*}_{\setminus E}}^{1/3})^{-\alpha -1}(1 + \frac{\omega}{3} {N^{*}_{\setminus E}}^{-2/3}) = \beta B \Big(\frac{C_{\setminus E}}{6}\Big)^{-\beta} {N^{*}_{\setminus E}}^{\beta -1} \\ & 6^{-\beta}\frac{\alpha A}{\beta B} ({N^{*}_{\setminus E}} + \omega {N^{*}_{\setminus E}}^{1/3})^{-\alpha -1}(1 + \frac{\omega}{3}{N^{*}_{\setminus E}}^{-2/3}) {N^{*}_{\setminus E}}^{1 - \beta} = C_{\setminus E}^{-\beta} \\ & 6 \Big(\frac{\beta B}{\alpha A}\Big)^{\frac{1}{\beta}} ({N^{*}_{\setminus E}} + \omega {N^{*}_{\setminus E}}^{1/3})^{\frac{1 + \alpha}{\beta}} ({N^{*}_{\setminus E}} + \frac{\omega}{3}{N^{*}_{\setminus E}}^{1/3})^{-\frac{1}{\beta}} {N^{*}_{\setminus E}} = C_{\setminus E} \end{align} \]上式中 \(C_{\setminus E}\) 与 \(N_{\setminus E}\) 的关系不再是一个干净的幂律。我们只能在局部把它近似为 \(N^*_{\setminus E} \overset{\propto}{\sim} C_{\setminus E}^g\),其中 \(g\) 是基于一阶导数的局部指数,而不是全局幂律指数,于是 \(g = \frac{\mathrm{d} \log C_{\setminus E}}{\mathrm{d} \log N_{\setminus E}}\)。关于如何近似指数 \(g\) 的完整细节,请见 Pearce & Song (2024) 附录 A.1。
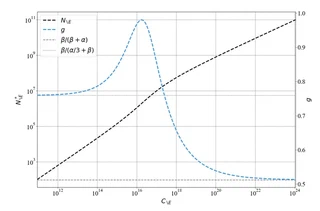
图:局部幂律指数 \(g\) 如何随 \(C_{\setminus E}\) 增大而变化。图片来源:Pearce & Song 2024。
如上图所示,随着 \(C_{\setminus E}\) 变大,\(g\) 会收敛到 Chinchilla 的估计值。他们用上面的方程生成合成训练曲线,并在 Kaplan et al. 中相同的模型规模范围,即 768M 到 1.5B 内估计出 \(g\) 接近 Kaplan 的系数 0.73。
为什么是幂律?
幂律在 AI 之外的许多领域也被广泛观察到,例如 Zipf 定律、无标度网络、城市缩放定律 以及许多复杂系统。反复出现的模式是:大事件稀有,小事件常见,并且规模和频率之间的关系往往在 log-log 尺度上接近直线。
为什么 LLM 缩放定律也呈现幂律形状?
部分受到不同领域呈现不同指数这一观察的启发(Hestness et al. 2017),一个早期解释来自 Sharma & Kaplan (2020):他们假设语言建模可以看作是在低维数据流形上做回归。更多模型参数可以诱导对数据流形的更细分割,从而带来更小的泛化误差。最简单地说,如果有效规模为 \(N\) 的模型把一个 \(d\) 维流形划分成 \(O(N)\) 个区域,那么典型线性分辨率会按 \(\sim N^{-1/d}\) 缩放。这与上面的缩放定律有类似的幂律形式。这个理论在无限数据、欠拟合区域最干净,但现实中估计数据流形的内在维度很困难。
另一个后来的假设(Michaud et al. 2023,Brill 2024)认为,知识或技能是以离散块的形式被学习的,即被“量化”,而这些技能的频率分布遵循幂律。模型先学习常见技能,再学习稀有技能,因此损失会呈现平滑的幂律下降。
我这里只列出两个假设,但还有更多研究从数据谱尾、核特征值、自然语言统计特性或训练动力学相变等角度解释幂律缩放的形状。
数据受限区域中的缩放定律
经典缩放定律假设有效上有无限的唯一数据、没有重复、没有多 epoch 训练。随着模型规模显著增长,我们正在耗尽足够高质量的唯一 token。事实上,关于 AI 缩放还能持续多久的一些争论,核心就在于我们是否正在撞上“数据墙”。
也值得强调的是,\(D\) 背后的数据集预期已经被清洗过。预训练数据流水线通常是有效预训练流水线中的重要部分,常见步骤包括去重(精确和模糊)、质量过滤、样板文本移除、安全过滤、PII 和版权遮蔽、benchmark 去污染,以及基于语言、质量、内容类型等对数据混合成分进行仔细重加权。即便两个数据集拥有相同 token 数 \(D\),一个高质量数据集和一个互联网垃圾数据集也可能带来截然不同的计算效率。
Hernandez et al. (2022) 的研究关注一个受控版本:一个大部分唯一、但含有少量重复数据的数据集。从一个大数据集出发,数据混合中保留 90% 非重复内容,但用原始数据中很小一部分的重复样本替换剩余 10%。他们训练一个 Transformer 模型 100B token 后,观察到 double descent 现象:随着重复数据权重增加,测试损失会先变差,然后又变好,而且重复比例越大,这个效应越明显。
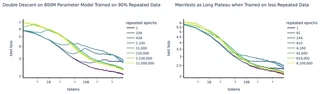
图:测试损失随重复比例增加出现 double descent,左侧重复比例为 90%,右侧为 50%。图片来源:Hernandez et al. 2022。
训练中段的平坦或上升趋势,可能是由于模型记忆重复数据造成的。具有这种形状的学习曲线会让缩放定律拟合不那么准确。他们还总结说,重复数据会损害某些 OOD 评测和下游微调。不过,他们的数据混合是更偏实验室的构造,而现实世界中的重复往往更微妙,例如不同数据有不同重复水平,也可能存在语义重复。
比起简单地说“数据重复会伤害训练”,我们更关心的是:当高质量唯一数据并非无限,而且训练中很可能必须重复数据时,该如何拟合缩放定律。
Muennighoff et al. (2023) 研究了在模型训练受数据约束时,应该如何最优分配计算量。具体来说,他们通过大约 400 个实验,经验研究数据重复的影响。模型范围为 10M 到 9B 参数,数据规模最高到 900B token,epoch 最高到 1500。每个 epoch 重复完全相同的数据集,epoch 之间打乱顺序,并在 held-out 测试集上评估。
关键建模调整是把总 token 数 \(D\) 分解成两部分:(i)唯一 token 数 \(U_D\),以及(ii)重复次数 \(R_D\),也就是 epoch 数减 1。因此 \(D = U_D(1 + R_D)\)。给定唯一数据预算 \(D_\text{uniq}\),按定义有 \(U_D = \min \{{ D_\text{uniq}, D\}}\),且 \(R_D = (D / U_D) - 1\)。他们使用 Chinchilla 缩放定律找到拟合 \(U_D\) 的最优模型规模 \(U_N\),并通过重复定义超额模型规模 \(R_N = (N / U_N) - 1\)。
然后,他们更新 Chinchilla 的参数化拟合方法 3,用有效的、经过折扣的数据量 \(D'\) 和模型规模 \(N'\) 替代原始量:
\[ \hat{L}(N, D) = \frac{A}{N'^\alpha} + \frac{B}{D'^\beta} + E \quad\text{ where } D' = U_D + U_D\, r_D\left(1 - \exp\!\left(-\frac{R_D}{r_D}\right)\right). \]直觉是,一个 token 的价值会随着重复而指数衰减。在他们的建模中,每次重复都会让该 token 剩余价值损失 \((1 - 1/r_D)\) 的比例,其中 \(r_D\) 是可学习的“半衰期”参数。当 \(R_D = 0\) 或 \(R_D \ll r_D\) 时,我们恢复 \(D' \approx D\)。
一个对称形式用于处理超额模型规模:\(N' = U_N + U_N r_N(1 - \exp(-R_N / r_N))\)。它刻画了“更大的模型会在重复数据上更快过拟合”,以及“一个模型可能对它的数据集来说太大”这些想法。这个部分不那么直观,我也没有找到令人满意的解释,说明为什么模型规模需要像重复数据一样以这种对称形式出现。后续 Lovelace et al. (2026) 改变了这个假设。
他们的经验拟合发现,超额参数的价值衰减速度比重复数据更快,即 \(r_N < r_D\),因此我们应该把更多资源分配给更多 epoch,而不是更多模型参数。这个建模的一个弱点,作者也指出过,是它会显著低估失败模型的最终测试损失,也就是训练中途损失开始上升的模型,例如训练 44 个 epoch 的模型。
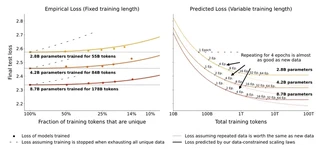
图:数据受限缩放模型比不考虑数据限制的拟合更好地捕捉实验结果;重复 token 的价值会指数衰减并趋向上限。随着 epoch 增多,拟合会变差,因为高度重复会导致测试损失在训练中途上升,但图中没有展示这一点。图片来源:Muennighoff et al. 2023。
最近,Lovelace et al. (2026) 用另一种方法重新研究了同一个问题。与其把过参数化建模为有效模型规模上的边际收益递减,Lovelace et al. 显式建模模型规模 \(\times\) 数据重复之间的交互。经验上,他们训练了约 300 个模型,范围从 15M 到 1B 参数,以及从 50M 到 6B 唯一 token。
当他们对固定模型规模绘制不同数据重复水平下的拟合残差时,观察很直观:epoch 越多,伤害越大;有趣的是,更大的模型对重复更敏感。这暗示损失惩罚很可能同时是模型规模和数据规模的函数。
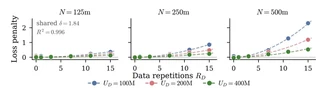
图:有效规模拟合的残差表明,过拟合伤害会随 epoch 数和模型规模同时增长。图片来源:Lovelace et al. 2026。
他们引入了一个显式过拟合惩罚项,并围绕容量比 \(N / U_D\) 构造,也就是参数量相对于唯一 token 的比例:
\[ \hat{L}(N, U_D, R_D) = E + \frac{A}{N^\alpha} + \frac{B}{\big(U_D (1 + R_D)\big)^\beta} + \color{red}{P \cdot R_D^\delta \cdot \left(\frac{N}{U_D}\right)^\kappa} \]其中:
- \(R_D\) 是重复次数;
- 标量 \(P\) 是可学习参数;
- 指数 \(\kappa\) 是第二个可学习参数,让惩罚项可以随容量比 \(N / U_D\) 非线性变化;
- 重复次数上的独立指数 \(\delta\) 是第三个可学习参数,它把重复的非线性从 \(\kappa\) 中解耦出来。
红色新增项是一个直接的过拟合惩罚,它会随着数据重复次数,以及模型相对于可用唯一数据的过参数化程度一起增长。
他们还做了一个关于 weight decay 如何影响数据受限训练的案例研究,发现更强的 weight decay 会降低数据重复导致的过拟合惩罚。
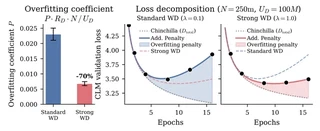
图:强 weight decay 会降低数据重复带来的过拟合惩罚。图片来源:Lovelace et al. 2026。
Muennighoff et al. 和 Lovelace et al. 的两种建模方法都来自经验曲线拟合,因此我们仍然不清楚为什么数据受限缩放定律应该恰好有这些形式,也不清楚为什么每个自由参数都是必要的。我很好奇这个方向上是否会有更多理论工作。
现实中拟合缩放定律的微妙之处
尽管缩放定律形式干净,但在实践中,它的拟合对一些看似琐碎的流程选择会出人意料地敏感,例如如何计算参数量、如何舍入精度、如何求和或平均损失等。
原因是,缩放定律只能在我们负担得起训练的相对小、相对便宜的模型上拟合,而预测结果要外推到大好几个数量级的模型。在这种设定下,看起来像舍入误差的选择,可能会导致非常不同的预测。
与此同时,缩放定律拟合假设唯一变化的因素是规模。这意味着模型架构、优化器、学习率计划、batch ramp、数据混合、tokenizer 和其他设计选择应该保持不变。另一个底层假设是,这些设置都已经被仔细调优,因为训练不足这类情况可能会导向不同结论。
Kaplan et al. 和 Chinchilla 结果之间的分歧,就是展示缩放定律拟合微妙之处的一个例子。
第二个例子是后续分析:为什么 Chinchilla 的方法 3 会与另外两种方法略有偏差?Besiroglu et al. (2024) 从 Hoffmann et al. (2022) 的 Figure 4 中提取原始 \((N, D, L)\) 数据点,并重新运行方法 3 的参数化拟合。他们发现了几个具体问题:
- L-BFGS-B 最小化器中的损失尺度过高,这是由于对 Huber-loss 按样本平均而不是求和导致的,进而造成优化过早终止。原始拟合和 bootstrap 中的损失最小化提前停止,产生了不一致的估计值和不合理地窄的置信区间。
- 报告的 \(\alpha\) 和 \(\beta\) 被舍入到 2 位小数,这让推导出的 \(A, B\) 看起来比实际偏差更大。
玩具模拟
下面是一个由 ChatGPT 创建的玩具模拟组件,用来展示三种具体失败模式。
我们假设真实函数为:
\[ \hat{L}(N, D) = 482.01 \cdot N^{-0.3478} + 2085.43 D^{-0.3658} + 1.8172 \]因此 \(N_\text{opt} \propto C^{0.5126}, D_\text{opt} \propto C^{0.4874}\)。这是 Besiroglu et al. (2024) 的估计。
该模拟绘制损失预测 \(\hat{L}\) 相对于数据规模 \(D\) 的曲线,同时提供几组滑块来展示:
- 损失精度:把损失从高精度舍入到低精度,会改变拟合得到的参数值。
- 损失噪声:只用 milli-loss(0.001)量级的倍数扰动损失值,就会导致不同拟合。
- 拟合区域敏感性:只拟合小模型、只拟合中等模型或拟合全部模型,会得到不同的表观缩放定律。
引用
请按如下方式引用原文:
Weng, Lilian. “Scaling Laws, Carefully”. Lil’Log (Jun 2026). https://lilianweng.github.io/posts/2026-06-24-scaling-laws/
或使用 BibTeX:
@article{weng2026scaling,
 title = {Scaling Laws, Carefully},
 author = {Weng, Lilian},
 journal = {lilianweng.github.io},
 year = {2026},
 month = {June},
 url = "https://lilianweng.github.io/posts/2026-06-24-scaling-laws/"
}
参考文献
[1] S. Amari, N. Fujita, and S. Shinomoto. “Four Types of Learning Curves. Neural Computation.” 4(4):605-618, 1992.
[2] Hestness et al. “Deep Learning Scaling is Predictable, Empirically.” arXiv preprint arXiv:1712.00409, 2017.
[3] Rosenfeld et al. “A Constructive Prediction of the Generalization Error Across Scales.” ICLR 2020.
[4] Kaplan et al. “Scaling Laws for Neural Language Models.” arXiv preprint arXiv:2001.08361, 2020.
[5] Hoffmann et al. “Training Compute-Optimal Large Language Models.” NeurIPS 2022.
[6] Pearce and Song. “Reconciling Kaplan and Chinchilla Scaling Laws.” TMLR 2024.
[7] Bahri et al. “Explaining Neural Scaling Laws.” arXiv preprint arXiv:2102.06701, 2021.
[8] Sharma and Kaplan. “A Neural Scaling Law from the Dimension of the Data Manifold.” arXiv preprint arXiv:2004.10802, 2020.
[9] Hernandez et al. “Scaling Laws and Interpretability of Learning from Repeated Data.” arXiv preprint arXiv:2205.10487, 2022.
[10] Muennighoff et al. “Scaling Data-Constrained Language Models.” NeurIPS 2023.
[11] Lovelace et al. “Prescriptive Scaling Laws for Data Constrained Training.” arXiv preprint arXiv:2605.01640, 2026.
[12] Besiroglu et al. “Chinchilla Scaling: A Replication Attempt.” arXiv preprint arXiv:2404.10102, 2024.
[13] Michaud et al. “The Quantization Model of Neural Scaling” NeurIPS 2023.
[14] Brill. “Neural Scaling Laws Rooted in the Data Distribution.” arXiv preprint arXiv:2412.07942, 2024.
[15] Rae et al. “Scaling Language Models: Methods, Analysis & Insights from Training Gopher.” arXiv preprint arXiv:2112.11446, 2021.